Về trang chủ Bizfly
 Đăng nhập
 Loading ...
Để dành mua sau (0 sản phẩm)
Không có sản phẩm nào trong danh sách để dành mua sau của bạn!
 Đỗ Minh Đức


Doanh nghiệp ngày càng phải xử lý lượng lớn thông tin từ email, hình ảnh, cuộc gọi đến video. Tuy nhiên, các hệ thống AI chỉ xử lý một loại dữ liệu thường gặp hạn chế khi cần liên kết thông tin từ nhiều nguồn. Multimodal AI (AI đa phương thức) mở ra khả năng kết hợp các dạng dữ liệu để hiểu ngữ cảnh và hỗ trợ xử lý công việc hiệu quả hơn. Vậy Multimodal AI là gì, hoạt động như thế nào và được ứng dụng ra sao trong thực tế? Cùng Bizfly tìm hiểu trong bài viết dưới đây.
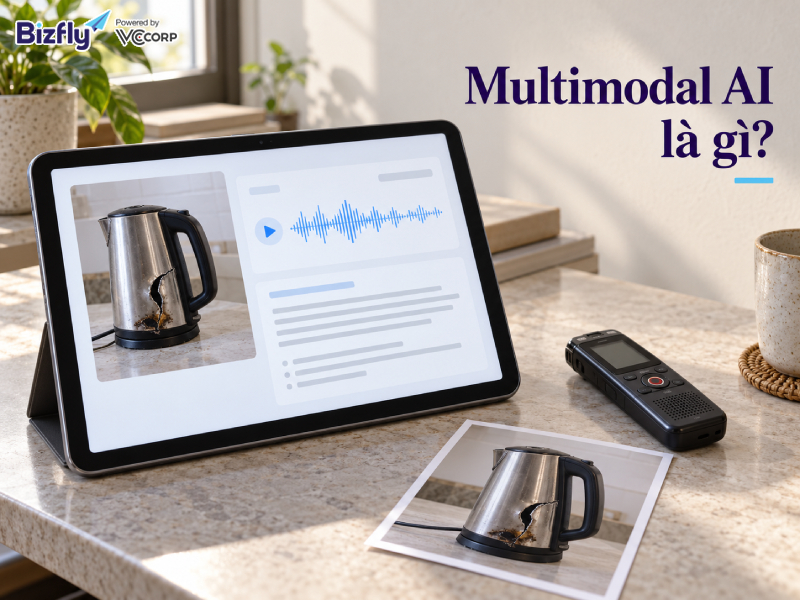
Multimodal AI (AI đa phương thức) là hệ thống trí tuệ nhân tạo có khả năng xử lý và kết hợp nhiều loại dữ liệu như văn bản, hình ảnh, âm thanh và video. Công nghệ này giúp AI hiểu ngữ cảnh từ nhiều nguồn thông tin để đưa ra kết quả phù hợp hơn.
Thuật ngữ modality chỉ một phương thức dữ liệu mà AI có thể xử lý, bao gồm:
Ví dụ: Khi người dùng gửi ảnh máy móc kèm câu hỏi về lỗi vận hành, Multimodal AI có thể phân tích cả hình ảnh và văn bản để hỗ trợ xác định vấn đề, đề xuất hướng kiểm tra.
Điểm nổi bật của AI đa phương thức là khả năng liên kết nhiều dạng dữ liệu thay vì chỉ xử lý một phương thức riêng lẻ.
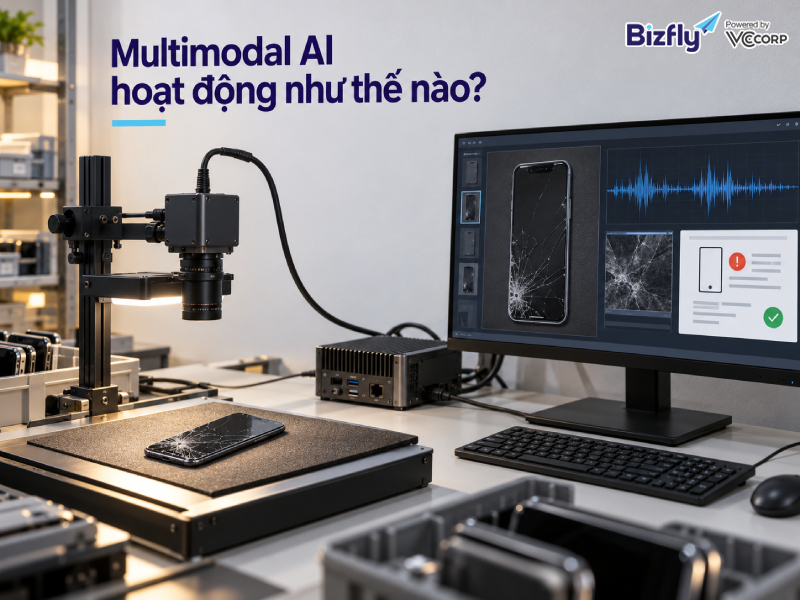
Multimodal AI hoạt động bằng cách tiếp nhận, xử lý và kết hợp nhiều phương thức dữ liệu để hiểu ngữ cảnh và tạo kết quả. Quy trình hoạt động của AI đa phương thức có thể khái quát thành 4 bước:
Hệ thống tiếp nhận dữ liệu từ nhiều nguồn như văn bản, hình ảnh, âm thanh hoặc video. Dữ liệu được chuẩn hóa, điều chỉnh định dạng và xử lý để phù hợp với yêu cầu của mô hình.
Ví dụ: Khách hàng gửi ảnh sản phẩm bị lỗi kèm mô tả sự cố. AI tiếp nhận cả hình ảnh và nội dung văn bản để chuẩn bị phân tích.
AI sử dụng các thành phần xử lý phù hợp để trích xuất đặc trưng từ từng loại dữ liệu và chuyển thành biểu diễn số (embedding).
Chẳng hạn, hệ thống nhận diện các chi tiết bất thường trên ảnh sản phẩm, đồng thời xác định thông tin quan trọng trong phần mô tả của khách hàng.
Mô hình liên kết thông tin giữa các phương thức dữ liệu để hiểu yêu cầu trong ngữ cảnh đầy đủ hơn. Quá trình này thường được gọi là multimodal fusion (hợp nhất dữ liệu đa phương thức).
Ví dụ, AI đối chiếu vị trí hư hỏng trên hình ảnh với mô tả “màn hình xuất hiện vết nứt” để xác định vấn đề khách hàng đang phản ánh.
Dựa trên thông tin đã kết hợp, Multimodal AI thực hiện tác vụ và tạo kết quả dưới dạng văn bản, hình ảnh, âm thanh hoặc định dạng khác tùy khả năng mô hình.
Trong tình huống trên, AI có thể tóm tắt sự cố, đề xuất bước kiểm tra ban đầu hoặc hỗ trợ phân loại yêu cầu bảo hành để nhân viên tiếp tục xử lý.
Multimodal AI, Unimodal AI và Generative AI đều thuộc lĩnh vực trí tuệ nhân tạo nhưng khác nhau về khả năng xử lý dữ liệu và mục đích sử dụng. Hiểu rõ sự khác biệt giúp doanh nghiệp lựa chọn công nghệ phù hợp với từng bài toán.
Unimodal AI (AI đơn phương thức) xử lý một loại dữ liệu, trong khi Multimodal AI (AI đa phương thức) có thể kết hợp nhiều loại dữ liệu để phân tích và hiểu ngữ cảnh.
| Tiêu chí | Unimodal AI | Multimodal AI |
| Dữ liệu đầu vào | Một phương thức | Hai hoặc nhiều phương thức |
| Khả năng xử lý | Tập trung vào một dạng dữ liệu | Liên kết thông tin từ nhiều dạng dữ liệu |
| Ví dụ | Phân loại hình ảnh | Trả lời câu hỏi dựa trên ảnh và văn bản |
| Độ phức tạp | Thường thấp hơn | Thường cao hơn do cần kết hợp dữ liệu |
Multimodal AI phù hợp với các tác vụ cần kết hợp nhiều nguồn thông tin. Tuy nhiên, Unimodal AI vẫn hiệu quả với những bài toán chuyên biệt, không yêu cầu xử lý đa phương thức.
Không hoàn toàn. Hai khái niệm mô tả những khả năng khác nhau của AI:
Một mô hình có thể kết hợp cả khả năng đa phương thức và Generative AI. Chẳng hạn, GPT-4o có thể phân tích hình ảnh cùng câu hỏi bằng văn bản và tạo câu trả lời phù hợp.
Multimodal AI được ứng dụng trong nhiều lĩnh vực nhờ khả năng kết hợp văn bản, hình ảnh, âm thanh và video để phân tích thông tin. Công nghệ này đặc biệt hữu ích với các nghiệp vụ cần xử lý nhiều loại dữ liệu cùng lúc, hỗ trợ doanh nghiệp tự động hóa quy trình và nâng cao hiệu quả vận hành.
Trong chăm sóc khách hàng bằng AI, AI đa phương thức có thể phân tích hình ảnh sản phẩm kết hợp nội dung khiếu nại để xác định vấn đề và phân loại yêu cầu.
Ví dụ, khi khách hàng gửi ảnh thiết bị bị hỏng kèm mô tả sự cố, AI hỗ trợ nhận diện dấu hiệu bất thường, tạo phiếu yêu cầu và chuyển đến bộ phận phụ trách. Nhờ đó, nhân viên giảm thao tác tiếp nhận thủ công.
Trong các ứng dụng AI trong Marketing, Multimodal AI hỗ trợ doanh nghiệp phân tích nội dung quảng cáo từ nhiều định dạng như video, hình ảnh, văn bản và âm thanh.
Chẳng hạn, AI có thể nhận diện các yếu tố xuất hiện trong video quảng cáo, phân tích lời thoại và tạo bản tóm tắt nội dung. Điều này giúp đội ngũ Marketing quản lý tài nguyên, phân loại chiến dịch và tái sử dụng nội dung trên nhiều kênh.
Khi ứng dụng AI trong y tế, Multimodal AI có thể kết hợp hình ảnh chẩn đoán, bệnh án điện tử và thông tin lâm sàng để hỗ trợ tổng hợp dữ liệu bệnh nhân.
Ví dụ, hệ thống AI phân tích hình ảnh X-quang cùng nội dung báo cáo y khoa nhằm hỗ trợ bác sĩ đối chiếu thông tin và phát hiện những điểm cần xem xét. Kết quả AI chỉ mang tính hỗ trợ, không thay thế đánh giá chuyên môn của bác sĩ.
Trong các ứng dụng AI trong giáo dục, AI đa phương thức giúp hệ thống học tập xử lý đồng thời câu hỏi, hình ảnh, biểu đồ và nội dung bài giảng để hỗ trợ người học.
Ví dụ, học sinh chụp ảnh bài toán có biểu đồ và yêu cầu giải thích. AI phân tích cả hình ảnh lẫn câu hỏi để đưa ra hướng dẫn từng bước. Công nghệ này hỗ trợ cá nhân hóa trải nghiệm học tập theo nhu cầu của từng người.
Trong các ứng dụng AI trong thương mại điện tử, Multimodal AI hỗ trợ tìm kiếm sản phẩm bằng cách kết hợp hình ảnh tham khảo với mô tả bằng văn bản.
Ví dụ, khách hàng tải ảnh một đôi giày và yêu cầu tìm mẫu tương tự nhưng có màu đen. AI phân tích đặc điểm hình ảnh cùng yêu cầu để đề xuất sản phẩm phù hợp trong danh mục. Nhờ đó, quá trình tìm kiếm trở nên thuận tiện hơn.
Khi ứng dụng AI trong sản xuất, Multimodal AI có thể kết hợp hình ảnh từ camera với dữ liệu cảm biến và nhật ký vận hành để hỗ trợ giám sát thiết bị.
Ví dụ, khi camera phát hiện dấu hiệu bất thường trên dây chuyền, AI đối chiếu với thông số vận hành để hỗ trợ xác định nguyên nhân. Điều này giúp bộ phận kỹ thuật phát hiện sớm vấn đề và ưu tiên kiểm tra những thiết bị có nguy cơ gặp sự cố.
Hiện nay, nhiều mô hình Multimodal AI được phát triển để xử lý kết hợp văn bản, hình ảnh, âm thanh và video. Trong đó, GPT-4o, Google Gemini và LLaVA là những ví dụ tiêu biểu, với khả năng và phạm vi ứng dụng khác nhau.
| Mô hình | Khả năng nổi bật | Ví dụ sử dụng |
| GPT-4o (OpenAI) | Có khả năng xử lý đa phương thức; các loại đầu vào và đầu ra khả dụng phụ thuộc giao diện triển khai | Trợ lý AI hội thoại, phân tích hình ảnh và trả lời câu hỏi |
| Google Gemini | Xử lý nhiều loại dữ liệu như văn bản, hình ảnh, âm thanh và video tùy phiên bản | Phân tích tài liệu, tóm tắt video, hỏi đáp đa phương tiện |
| LLaVA | Kết hợp khả năng hiểu hình ảnh và ngôn ngữ | Mô tả hình ảnh, hỏi đáp dựa trên nội dung ảnh |
Mỗi mô hình có thế mạnh và giới hạn riêng về loại dữ liệu hỗ trợ, khả năng tạo đầu ra, chi phí và phương thức triển khai. Chẳng hạn, GPT-4o và Gemini có thể được sử dụng thông qua các dịch vụ API, trong khi một số phiên bản LLaVA cho phép triển khai trên hạ tầng riêng.
Doanh nghiệp nên lựa chọn mô hình Multimodal AI dựa trên nhu cầu xử lý dữ liệu, yêu cầu bảo mật, khả năng tích hợp và ngân sách. Đồng thời, cần kiểm tra tài liệu chính thức vì tính năng có thể thay đổi theo phiên bản và môi trường sử dụng.
Multimodal AI giúp doanh nghiệp khai thác thông tin từ nhiều loại dữ liệu, hỗ trợ tự động hóa và nâng cao trải nghiệm khách hàng. Tuy nhiên, công nghệ này cũng đặt ra thách thức về độ chính xác, chi phí triển khai và bảo mật dữ liệu.
Dưới đây là những lợi ích và hạn chế của AI đa phương thức:
| Khía cạnh | Lợi ích | Hạn chế |
| Hiểu ngữ cảnh | Kết hợp văn bản, hình ảnh, âm thanh để phân tích thông tin toàn diện hơn | Có thể liên kết sai dữ liệu, dẫn đến kết quả thiếu chính xác |
| Tự động hóa | Hỗ trợ xử lý nghiệp vụ liên quan đến nhiều định dạng dữ liệu | Tích hợp với hệ thống hiện có có thể phức tạp |
| Trải nghiệm người dùng | Cho phép tương tác linh hoạt bằng văn bản, giọng nói và hình ảnh | Khả năng tương tác phụ thuộc vào từng mô hình |
| Hiệu quả vận hành | Giảm thao tác thủ công trong tiếp nhận, phân tích và xử lý thông tin | Chi phí tính toán và vận hành có thể cao |
| Bảo mật dữ liệu | Hỗ trợ phân tích thông tin trong các quy trình có kiểm soát | Đòi hỏi quản lý quyền truy cập và bảo vệ dữ liệu nhạy cảm |
Mặc dù có nhiều lợi ích, Multimodal AI không đảm bảo kết quả luôn chính xác. Chất lượng đầu ra phụ thuộc vào mô hình, dữ liệu đầu vào và khả năng kết hợp thông tin giữa các phương thức.
Vì vậy, doanh nghiệp cần kiểm thử trên từng nghiệp vụ, đánh giá độ chính xác và duy trì cơ chế giám sát của con người, đặc biệt với các quyết định liên quan đến tài chính, y tế hoặc dữ liệu nhạy cảm.
Doanh nghiệp nên triển khai Multimodal AI khi quy trình cần kết hợp nhiều loại dữ liệu và các giải pháp AI đơn phương thức chưa đáp ứng hiệu quả. Trước khi đầu tư, cần đánh giá bốn yếu tố:
Doanh nghiệp nên bắt đầu bằng một dự án thử nghiệm quy mô nhỏ (PoC), so sánh kết quả với giải pháp đơn phương thức hoặc quy trình hiện tại. Chỉ nên mở rộng khi công nghệ chứng minh được hiệu quả, đáp ứng yêu cầu bảo mật và có khả năng vận hành ổn định.
Có. ChatGPT hỗ trợ xử lý nhiều phương thức dữ liệu như văn bản, hình ảnh và âm thanh. Người dùng có thể đặt câu hỏi về hình ảnh hoặc tương tác bằng giọng nói. Tuy nhiên, khả năng cụ thể phụ thuộc vào mô hình, tính năng và gói dịch vụ được sử dụng.
Không bắt buộc. Doanh nghiệp có thể sử dụng các mô hình Multimodal AI được huấn luyện sẵn thông qua API hoặc nền tảng AI. Việc tinh chỉnh mô hình bằng dữ liệu riêng chỉ cần thiết khi bài toán có yêu cầu đặc thù mà mô hình hiện tại chưa đáp ứng tốt.
Không. AI đơn phương thức vẫn phù hợp với các tác vụ chuyên biệt như phân loại văn bản, nhận diện hình ảnh hoặc xử lý giọng nói. Doanh nghiệp nên lựa chọn công nghệ dựa trên yêu cầu dữ liệu, độ chính xác và chi phí vận hành.
Multimodal AI mở rộng khả năng của trí tuệ nhân tạo thông qua việc xử lý và liên kết nhiều loại dữ liệu như văn bản, hình ảnh, âm thanh và video. Công nghệ này mang lại tiềm năng ứng dụng trong nhiều lĩnh vực, từ chăm sóc khách hàng đến vận hành doanh nghiệp. Tuy nhiên, để triển khai hiệu quả, doanh nghiệp cần xác định đúng bài toán, đánh giá chất lượng dữ liệu và lựa chọn mô hình phù hợp với nhu cầu thực tế thay vì chạy theo xu hướng công nghệ.
 Ứng dụng AI
BIZFLY AI - HỆ SINH THÁI GIẢI PHÁP AI CHO DOANH NGHIỆP
AI Agent giúp tối ưu nguồn lực và chi phí, giúp doanh nghiệp phát triển bền vững trong kỷ nguyên AI