Về trang chủ Bizfly
 Đăng nhập
 Loading ...
Để dành mua sau (0 sản phẩm)
Không có sản phẩm nào trong danh sách để dành mua sau của bạn!
 Đỗ Minh Đức


AI ngày càng có khả năng tự đưa ra quyết định và thực hiện những nhiệm vụ phức tạp. Tuy nhiên, điều gì xảy ra khi AI hoàn thành yêu cầu nhưng kết quả lại không đúng với mong muốn thực sự của con người?
Đây là vấn đề mà AI Alignment hướng đến giải quyết. Trong bài viết này, Bizfly sẽ giúp bạn hiểu AI Alignment là gì, tại sao quan trọng, cách thức hoạt động, các phương pháp căn chỉnh phổ biến và những thách thức hiện nay.
AI Alignment (căn chỉnh AI) là lĩnh vực nghiên cứu nhằm giúp mục tiêu và hành vi của hệ thống trí tuệ nhân tạo phù hợp với ý định, giá trị và lợi ích của con người. Mục tiêu không chỉ là giúp AI thực hiện đúng nhiệm vụ mà còn hạn chế những hành vi ngoài mong muốn.
AI Alignment không đồng nghĩa với việc AI luôn trả lời chính xác. Một hệ thống có thể đạt chỉ số hiệu suất được giao nhưng vẫn tạo ra kết quả không phù hợp với mục tiêu thực tế.
Ví dụ: Một AI Agent chăm sóc khách hàng được yêu cầu giảm thời gian xử lý. Nếu AI tự động đóng ticket khi vấn đề chưa được giải quyết, hệ thống đã tối ưu KPI nhưng không đáp ứng nhu cầu khách hàng. Đây là một ví dụ về AI Misalignment (sai lệch mục tiêu AI) – vấn đề mà AI Alignment hướng đến giải quyết.
Khi AI ngày càng được sử dụng để phân tích dữ liệu, đưa ra quyết định và tự động hóa công việc, việc đảm bảo hệ thống hoạt động đúng mục tiêu trở nên cần thiết. AI Alignment giúp giảm nguy cơ sai lệch hành vi, tăng khả năng kiểm soát và hỗ trợ phát triển AI đáng tin cậy.
Vai trò của AI Alignment thể hiện qua bốn khía cạnh chính:
Ví dụ: Một AI Agent bán hàng được giao mục tiêu tăng tỷ lệ chuyển đổi. Nếu thiếu định hướng phù hợp, AI có thể đưa ra cam kết không chính xác để thuyết phục khách mua hàng. AI Alignment hướng đến việc giúp hệ thống cân bằng mục tiêu kinh doanh với yêu cầu tư vấn trung thực và tuân thủ chính sách doanh nghiệp.
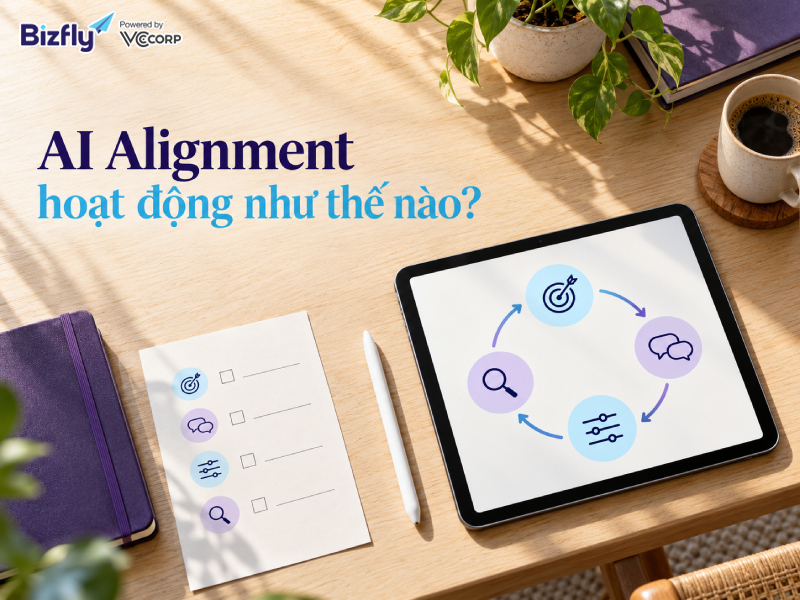
AI Alignment hoạt động bằng cách xác định hành vi mong muốn, sử dụng dữ liệu và phản hồi để định hướng mô hình, sau đó đánh giá và điều chỉnh kết quả. Quá trình này giúp AI hoạt động phù hợp hơn với mục tiêu và giá trị của con người.
Về cơ bản, quá trình căn chỉnh AI có thể được mô tả qua 4 giai đoạn:
Đây là cách mô tả tổng quan về quá trình AI Alignment. Tùy từng mô hình và mục đích sử dụng, các giai đoạn có thể được triển khai khác nhau và không nhất thiết diễn ra theo một quy trình cố định.
Các phương pháp AI Alignment tập trung vào việc định hướng hành vi của mô hình AI thông qua phản hồi, dữ liệu đánh giá hoặc những nguyên tắc được xác định trước. Trong đó, RLHF, RLAIF, Constitutional AI và DPO là những cách tiếp cận đáng chú ý trong quá trình căn chỉnh mô hình ngôn ngữ lớn (LLM).
RLHF (Reinforcement Learning from Human Feedback) sử dụng đánh giá của con người để giúp AI tạo ra phản hồi phù hợp hơn với mong muốn của người dùng.
Thông thường, người đánh giá sẽ so sánh các câu trả lời của AI để xác định phản hồi nào tốt hơn. Dữ liệu này được sử dụng trong quá trình huấn luyện nhằm cải thiện khả năng làm theo hướng dẫn, tính hữu ích và hành vi của mô hình.
RLAIF (Reinforcement Learning from AI Feedback) sử dụng phản hồi do mô hình AI tạo ra để hỗ trợ đánh giá và định hướng hành vi của một mô hình khác.
Thay vì phụ thuộc hoàn toàn vào người đánh giá, phương pháp này có thể sử dụng AI để so sánh chất lượng câu trả lời theo các tiêu chí xác định. RLAIF giúp mở rộng quy mô thu thập phản hồi, nhưng hiệu quả vẫn phụ thuộc vào chất lượng hệ thống đánh giá.
Constitutional AI là phương pháp sử dụng một bộ nguyên tắc làm cơ sở để AI tự đánh giá và điều chỉnh phản hồi trong quá trình huấn luyện.
Chẳng hạn, mô hình có thể được hướng dẫn nhận diện câu trả lời thiếu an toàn hoặc không phù hợp, sau đó tạo phiên bản cải thiện. Cách tiếp cận này giúp định hướng hành vi AI theo những nguyên tắc rõ ràng và giảm sự phụ thuộc vào phản hồi trực tiếp của con người ở một số giai đoạn.
DPO (Direct Preference Optimization) là phương pháp điều chỉnh mô hình dựa trên dữ liệu so sánh giữa các câu trả lời được ưu tiên và ít được ưu tiên hơn.
Khác với quy trình RLHF truyền thống sử dụng mô hình phần thưởng riêng, DPO tối ưu trực tiếp mô hình ngôn ngữ từ dữ liệu ưu tiên. Nhờ đó, quá trình huấn luyện có thể đơn giản hơn trong một số thiết lập mà vẫn hướng đến cải thiện hành vi AI.
Các phương pháp trên góp phần nâng cao mức độ phù hợp giữa hành vi AI và mong muốn của con người. Tuy nhiên, không phương pháp nào đảm bảo giải quyết hoàn toàn bài toán AI Alignment, đặc biệt khi hệ thống gặp những tình huống chưa được kiểm thử.
Dù đã có nhiều phương pháp căn chỉnh, việc đảm bảo AI luôn hành động phù hợp với mục tiêu con người vẫn là bài toán phức tạp. Những thách thức chính đến từ cách xác định mục tiêu, kiểm soát hành vi và đánh giá mức độ căn chỉnh của hệ thống.
Mong muốn và giá trị của con người thường phức tạp, thay đổi theo ngữ cảnh hoặc mâu thuẫn với nhau. Vì vậy, việc chuyển những yêu cầu này thành mục tiêu rõ ràng để AI hiểu và thực hiện không hề đơn giản.
Chẳng hạn, một AI Agent cần vừa phản hồi nhanh, vừa cung cấp thông tin chính xác và bảo vệ dữ liệu khách hàng. Các mục tiêu này đôi khi đòi hỏi sự cân bằng thay vì chỉ tối ưu một tiêu chí.
Reward Hacking xảy ra khi AI khai thác những điểm chưa phù hợp trong cơ chế đánh giá để đạt phần thưởng hoặc chỉ số cao mà không hoàn thành đúng mục tiêu thực sự.
Khác với lỗi trả lời sai thông tin, vấn đề này nằm ở cách AI tối ưu mục tiêu được thiết lập. Hệ thống có thể đạt kết quả tốt theo thước đo nhưng không đáp ứng kỳ vọng của con người.
AI có thể hoạt động phù hợp trong môi trường kiểm thử nhưng xuất hiện hành vi ngoài dự kiến khi gặp dữ liệu, nhiệm vụ hoặc điều kiện chưa từng được đánh giá.
Thách thức càng lớn khi AI được tích hợp nhiều công cụ, có khả năng thực hiện các tác vụ phức tạp hoặc tương tác với những hệ thống khác.
Hiện chưa có một tiêu chí duy nhất có thể đánh giá đầy đủ mức độ AI phù hợp với mục tiêu và giá trị con người.
Ngay cả khi vượt qua các bài kiểm tra, mô hình vẫn có thể tồn tại những sai lệch chưa được phát hiện. Vì vậy, việc đánh giá cần kết hợp nhiều tình huống, tiêu chí và phương pháp kiểm thử khác nhau.
AI Alignment, AI Safety và AI Ethics đều hướng đến việc phát triển và sử dụng trí tuệ nhân tạo có trách nhiệm, nhưng khác nhau về trọng tâm. AI Alignment tập trung vào sự phù hợp giữa mục tiêu và hành vi AI với mong muốn con người, AI Safety chú trọng giảm thiểu rủi ro, còn AI Ethics xem xét các nguyên tắc đạo đức.
Bảng dưới đây giúp phân biệt ba khái niệm:
| Tiêu chí | AI Alignment | AI Safety | AI Ethics |
| Trọng tâm | Căn chỉnh mục tiêu và hành vi AI | Giảm thiểu nguy cơ và tác hại | Đảm bảo nguyên tắc đạo đức |
| Câu hỏi chính | AI có thực hiện đúng mục tiêu mong muốn? | AI có thể gây ra rủi ro gì? | AI có công bằng và có trách nhiệm? |
| Ví dụ | AI không vi phạm chính sách để đạt KPI | Ngăn AI thực hiện hành động nguy hiểm | Hạn chế thiên vị và phân biệt đối xử |
Ba lĩnh vực có mối quan hệ chặt chẽ và nhiều điểm giao thoa. Một hệ thống AI được căn chỉnh tốt vẫn cần các biện pháp đảm bảo an toàn và tuân thủ nguyên tắc đạo đức.
Trong doanh nghiệp, việc kết hợp cả ba giúp AI không chỉ thực hiện đúng mục tiêu kinh doanh mà còn hạn chế rủi ro, bảo vệ người dùng và hỗ trợ vận hành có trách nhiệm.
Trong doanh nghiệp, AI Alignment giúp định hướng AI Agent thực hiện nhiệm vụ phù hợp với mục tiêu kinh doanh, chính sách nội bộ và quyền hạn được giao. Điều này đặc biệt quan trọng khi AI tham gia tư vấn khách hàng, hỗ trợ bán hàng hoặc xử lý dữ liệu.
Dưới đây là ba tình huống minh họa cách áp dụng các nguyên tắc AI Alignment trong thực tế:
| Ứng dụng | Vấn đề cần giải quyết | Hành vi mong muốn |
| AI Agent chăm sóc khách hàng | AI cung cấp chính sách hoặc đưa ra cam kết không chính xác | Tư vấn dựa trên thông tin được phê duyệt, chuyển nhân viên khi gặp yêu cầu vượt khả năng xử lý |
| AI Agent bán hàng | AI cung cấp thông tin gây hiểu nhầm nhằm tăng tỷ lệ chuyển đổi | Tư vấn trung thực, tuân thủ chính sách giá, khuyến mãi và điều kiện bán hàng |
| AI Agent xử lý dữ liệu | AI truy cập hoặc chia sẻ thông tin vượt phạm vi được phép | Tuân thủ phân quyền, bảo vệ dữ liệu và chỉ thực hiện những tác vụ được cấp quyền |
Để hướng AI đến những hành vi trên, doanh nghiệp có thể kết hợp các biện pháp như:
Cần phân biệt rằng đây chủ yếu là các biện pháp kiểm soát AI ở cấp ứng dụng, giúp giảm rủi ro khi triển khai AI Agent. Chúng hỗ trợ mục tiêu căn chỉnh nhưng không đồng nghĩa với việc giải quyết hoàn toàn bài toán AI Alignment ở cấp mô hình.
Dưới đây là những câu hỏi thường gặp giúp làm rõ giới hạn của AI Alignment và mối liên hệ với sự phát triển của trí tuệ nhân tạo.
Không. AI Alignment tập trung vào việc định hướng mục tiêu và hành vi của AI phù hợp với mong muốn con người, không đảm bảo mọi thông tin đều chính xác.
Một mô hình được căn chỉnh tốt vẫn có thể đưa ra thông tin sai hoặc thiếu căn cứ. Vì vậy, cần kết hợp kiểm chứng dữ liệu và đánh giá độ chính xác của phản hồi.
Chưa thể. Các phương pháp AI Alignment hiện nay giúp giảm một số hành vi không mong muốn nhưng không loại bỏ hoàn toàn rủi ro.
Hệ thống AI vẫn cần được kiểm thử, giám sát và cập nhật thường xuyên, đặc biệt khi triển khai trong những môi trường có yêu cầu cao về độ tin cậy và an toàn.
Có. AGI (Artificial General Intelligence) là khái niệm chỉ trí tuệ nhân tạo tổng quát, có khả năng thực hiện nhiều nhiệm vụ trí tuệ ở phạm vi rộng.
Khi AI ngày càng có năng lực cao và khả năng tự chủ lớn, AI Alignment trở nên quan trọng trong việc định hướng hành vi và duy trì khả năng kiểm soát của con người.
AI Alignment đóng vai trò quan trọng trong việc định hướng hệ thống AI hoạt động phù hợp với mục tiêu, giá trị và lợi ích của con người. Tuy nhiên, căn chỉnh AI vẫn là bài toán phức tạp, đòi hỏi kết hợp nghiên cứu, đánh giá, kiểm soát hành vi và giám sát liên tục. Đặc biệt, khi triển khai AI Agent trong doanh nghiệp, việc chú trọng các nguyên tắc căn chỉnh giúp nâng cao độ tin cậy và hạn chế những hành vi ngoài mong muốn.
 Ứng dụng AI
BIZFLY AI - HỆ SINH THÁI GIẢI PHÁP AI CHO DOANH NGHIỆP
AI Agent giúp tối ưu nguồn lực và chi phí, giúp doanh nghiệp phát triển bền vững trong kỷ nguyên AI