Về trang chủ Bizfly
 Đăng nhập
 Loading ...
Để dành mua sau (0 sản phẩm)
Không có sản phẩm nào trong danh sách để dành mua sau của bạn!
 Đỗ Minh Đức


Chatbot AI có thể trả lời khách hàng trong vài giây, AI nhận diện hình ảnh giúp phát hiện lỗi sản phẩm, còn AI Agent hỗ trợ xử lý nhiều yêu cầu phức tạp. Nhưng điều gì diễn ra khi dữ liệu được gửi đến mô hình AI và yếu tố nào quyết định tốc độ, chất lượng phản hồi?
Để hiểu rõ cách các ứng dụng này vận hành, bài viết sẽ làm rõ AI Inference là gì, cách hoạt động, các hình thức triển khai và những yếu tố ảnh hưởng đến hiệu quả, chi phí sử dụng. Cùng Bizfly tìm hiểu chi tiết trong nội dung dưới đây!
AI Inference (suy luận AI) là quá trình mô hình trí tuệ nhân tạo đã được huấn luyện sử dụng dữ liệu đầu vào để tạo ra kết quả như dự đoán, phân loại, nhận diện hoặc phản hồi. Đây là giai đoạn mô hình AI được ứng dụng vào thực tế để xử lý các yêu cầu mới mà không cần huấn luyện lại cho mỗi lần sử dụng.
Tùy theo nhiệm vụ, AI Inference có thể xử lý nhiều loại dữ liệu và tạo ra những kết quả khác nhau:
Ví dụ, khi người dùng đặt câu hỏi cho ChatGPT, mô hình ngôn ngữ xử lý nội dung được cung cấp và tạo phản hồi. Quá trình mô hình thực hiện tính toán để sinh ra câu trả lời chính là AI Inference.
Trong doanh nghiệp, đây là hoạt động cốt lõi phía sau nhiều ứng dụng như Chatbot AI, AI Agent và tổng đài AI, giúp hệ thống xử lý thông tin và hỗ trợ các nghiệp vụ thực tế.
AI Inference thường diễn ra qua ba giai đoạn chính: tiếp nhận và chuẩn bị dữ liệu đầu vào (Input), sử dụng mô hình đã huấn luyện để xử lý dữ liệu (Model), sau đó tạo kết quả trả về ứng dụng (Output).
Sơ đồ khái quát quy trình AI Inference:
Input → Model → Output
Hệ thống tiếp nhận dữ liệu từ người dùng hoặc ứng dụng, chẳng hạn như câu hỏi, hình ảnh, âm thanh hoặc thông tin giao dịch. Dữ liệu sau đó được chuẩn hóa và chuyển đổi sang định dạng phù hợp để mô hình AI xử lý.
Ví dụ, khi khách hàng gửi câu hỏi cho chatbot, nội dung văn bản được chuyển thành các token và biểu diễn số để mô hình ngôn ngữ lớn có thể tiếp nhận.
Mô hình sử dụng các tham số đã học trong quá trình huấn luyện để phân tích dữ liệu đầu vào và tạo kết quả. Tùy nhiệm vụ, kết quả có thể là dự đoán, phân loại, nhận diện đối tượng hoặc nội dung phản hồi.
Với Generative AI, đặc biệt là mô hình ngôn ngữ lớn (LLM), quá trình LLM inference thường tạo phản hồi lần lượt theo từng token cho đến khi hoàn thành câu trả lời hoặc đạt điều kiện dừng.
Kết quả suy luận được chuyển đến ứng dụng hoặc hệ thống nghiệp vụ. Tùy yêu cầu, hệ thống có thể kiểm tra, bổ sung thông tin hoặc chuyển kết quả cho nhân viên trước khi hiển thị đến người dùng.
Chẳng hạn, chatbot AI có thể sử dụng phản hồi từ mô hình để trả lời khách hàng, đồng thời ghi nhận thông tin hội thoại vào CRM khi được tích hợp và cấp quyền phù hợp.
AI Training và AI Inference là hai giai đoạn khác nhau trong vòng đời của mô hình trí tuệ nhân tạo. AI Training giúp mô hình học từ dữ liệu bằng cách điều chỉnh các tham số, trong khi AI Inference sử dụng mô hình đã huấn luyện để xử lý dữ liệu mới và tạo ra dự đoán hoặc phản hồi.
Sự khác biệt giữa AI Training và AI Inference được thể hiện qua các tiêu chí sau:
| Tiêu chí | AI Training (Huấn luyện AI) | AI Inference (Suy luận AI) |
| Mục đích | Giúp mô hình học từ dữ liệu | Sử dụng mô hình để tạo kết quả |
| Dữ liệu | Dữ liệu huấn luyện | Dữ liệu đầu vào mới |
| Tham số mô hình | Được điều chỉnh trong quá trình học | Thường được giữ cố định |
| Kết quả | Mô hình được huấn luyện | Dự đoán, phân loại hoặc phản hồi |
| Tài nguyên | Phụ thuộc quy mô mô hình và dữ liệu huấn luyện | Phụ thuộc mô hình, độ phức tạp yêu cầu và lưu lượng xử lý |
| Thời điểm | Khi xây dựng hoặc cập nhật mô hình | Khi mô hình được sử dụng trong thực tế |
Ví dụ: Trong hệ thống kiểm tra chất lượng sản phẩm, AI Training sử dụng tập hình ảnh sản phẩm đạt chuẩn và bị lỗi để huấn luyện mô hình nhận diện đặc điểm bất thường. Khi hệ thống tiếp nhận hình ảnh sản phẩm mới, AI Inference sử dụng mô hình đã học để xác định sản phẩm có dấu hiệu lỗi hay không.
Ngoài ra, cần phân biệt AI Inference với Fine-tuning. Fine-tuning là quá trình tiếp tục huấn luyện nhằm điều chỉnh mô hình đã có cho một nhiệm vụ hoặc bộ dữ liệu cụ thể, còn inference chỉ sử dụng mô hình để tạo kết quả mà không trực tiếp cập nhật tham số.
AI Inference được phân loại theo hai tiêu chí chính: cách xử lý dữ liệu và môi trường triển khai. Tùy vào yêu cầu về tốc độ phản hồi, khối lượng dữ liệu và điều kiện vận hành, doanh nghiệp có thể lựa chọn hình thức phù hợp. Hai cách phân loại này bổ sung cho nhau và có thể kết hợp trong cùng một hệ thống AI.
Dựa trên thời điểm và phương thức xử lý yêu cầu, AI Inference gồm hai hình thức phổ biến:
| Hình thức | Đặc điểm | Ví dụ ứng dụng |
| Real-time Inference (Suy luận thời gian thực) | Xử lý dữ liệu khi phát sinh yêu cầu, ưu tiên độ trễ thấp để phản hồi nhanh | Chatbot AI trả lời khách hàng trong cuộc hội thoại |
| Batch Inference (Suy luận theo lô) | Xử lý tập hợp nhiều dữ liệu theo lịch hoặc từng đợt, không yêu cầu phản hồi tức thời | Phân loại hàng nghìn phản hồi khách hàng để phục vụ phân tích |
Real-time Inference phù hợp với các nghiệp vụ cần tương tác liên tục, trong khi Batch Inference thích hợp cho những tác vụ xử lý dữ liệu số lượng lớn mà không cần kết quả ngay lập tức.
Xét theo vị trí thực hiện suy luận, AI Inference có hai hình thức phổ biến:
| Hình thức | Đặc điểm | Ví dụ ứng dụng |
| Cloud Inference | Mô hình AI xử lý dữ liệu trên hạ tầng điện toán đám mây, thuận tiện mở rộng tài nguyên | Chatbot AI sử dụng mô hình được cung cấp qua dịch vụ Cloud |
| Edge Inference | Thực hiện suy luận trực tiếp trên thiết bị hoặc hệ thống gần nguồn dữ liệu | Camera AI phát hiện lỗi sản phẩm tại nhà máy |
Việc lựa chọn Cloud hay Edge Inference phụ thuộc vào yêu cầu về kết nối mạng, độ trễ, bảo mật dữ liệu và khả năng vận hành. Doanh nghiệp cũng có thể kết hợp cả hai để đáp ứng những nhu cầu xử lý khác nhau.
AI Inference được ứng dụng trong các hệ thống trí tuệ nhân tạo để xử lý dữ liệu mới và tạo ra kết quả phục vụ hoạt động thực tế, từ trả lời khách hàng, phân tích thông tin đến dự báo và phát hiện bất thường.
Trong doanh nghiệp, quá trình suy luận AI là thành phần quan trọng giúp các mô hình đã huấn luyện hỗ trợ tự động hóa và ra quyết định.
Dưới đây là những ứng dụng AI Inference phổ biến:
| Ứng dụng | Vai trò của AI Inference | Ví dụ thực tế |
| Chatbot AI | Phân tích câu hỏi và tạo phản hồi phù hợp với nội dung hội thoại | Giải đáp thắc mắc về sản phẩm, chính sách bán hàng |
| AI Agent | Hỗ trợ phân tích yêu cầu, lập kế hoạch và tạo đầu ra phục vụ thực hiện tác vụ | Phân loại yêu cầu khách hàng, đề xuất bước xử lý tiếp theo |
| Tổng đài AI | Hỗ trợ nhận diện giọng nói, xử lý ngôn ngữ và tạo phản hồi | Tiếp nhận cuộc gọi, giải đáp thông tin, hỗ trợ đặt lịch |
| Ngân hàng | Phân tích giao dịch và xác định các dấu hiệu bất thường | Cảnh báo giao dịch có nguy cơ gian lận |
| Y tế | Phân tích hình ảnh hoặc dữ liệu y khoa để hỗ trợ chuyên gia | Hỗ trợ phát hiện dấu hiệu bất thường trên hình ảnh chẩn đoán |
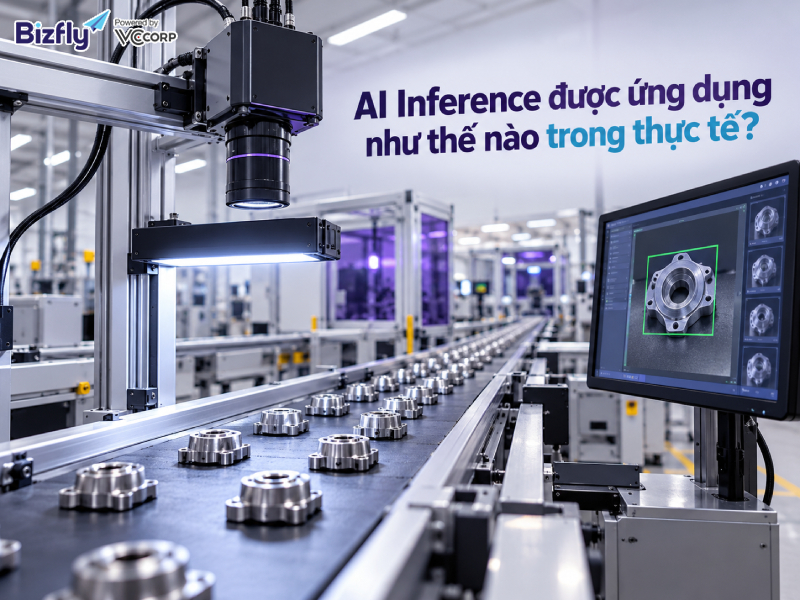
| Sản xuất | Nhận diện, phân loại sản phẩm dựa trên hình ảnh | Phát hiện sản phẩm có dấu hiệu lỗi trên dây chuyền |
Trong các giải pháp như AI Agent hoặc tổng đài AI, inference giúp mô hình xử lý yêu cầu và tạo kết quả để hệ thống tiếp tục thực hiện các nghiệp vụ như tư vấn, ghi nhận thông tin hoặc chuyển yêu cầu đến nhân viên.
Tuy nhiên, AI Inference không đồng nghĩa với toàn bộ quy trình tự động hóa. Để ứng dụng hiệu quả, doanh nghiệp cần kết hợp mô hình AI với dữ liệu nghiệp vụ, hệ thống quản lý, các công cụ tích hợp và cơ chế kiểm soát phù hợp. Việc kết nối AI Agent với API và hệ thống backend giúp chuyển đầu ra của mô hình thành thao tác cụ thể như tra cứu đơn hàng hoặc cập nhật CRM theo quyền được cấp.
Hiệu quả AI Inference phụ thuộc vào tốc độ phản hồi, khả năng xử lý yêu cầu, chất lượng kết quả, quy mô mô hình và hạ tầng tính toán. Những yếu tố này không chỉ quyết định trải nghiệm người dùng mà còn ảnh hưởng trực tiếp đến chi phí AI Inference khi doanh nghiệp triển khai và mở rộng hệ thống.
Dưới đây là các yếu tố doanh nghiệp cần đánh giá:
| Yếu tố | Ý nghĩa | Doanh nghiệp cần quan tâm |
| Latency (Độ trễ) | Thời gian từ khi gửi yêu cầu đến khi nhận kết quả hoặc token đầu tiên, tùy cách đo | Khách hàng phải chờ bao lâu để nhận phản hồi? |
| Throughput (Thông lượng) | Khối lượng yêu cầu hoặc token hệ thống xử lý trong một đơn vị thời gian | Hệ thống có đáp ứng được lưu lượng cao điểm không? |
| Chất lượng đầu ra | Mức độ chính xác, phù hợp và đáng tin cậy của kết quả | AI có đáp ứng yêu cầu nghiệp vụ không? |
| Quy mô mô hình | Kích thước và độ phức tạp của mô hình | Có cần sử dụng mô hình lớn cho mọi tác vụ không? |
| Hạ tầng tính toán | CPU, GPU và môi trường triển khai Cloud hoặc Edge | Phương án nào cân bằng hiệu suất và chi phí? |
| Chi phí sử dụng | Chi phí tài nguyên tính toán hoặc số lượng token xử lý | Chi phí trung bình cho mỗi yêu cầu là bao nhiêu? |
Ví dụ minh họa (giả định): Một chatbot AI xử lý 10.000 yêu cầu/ngày, trung bình mỗi yêu cầu sử dụng 1.000 input token và 300 output token. Tổng mức sử dụng ước tính là:
Doanh nghiệp có thể kết hợp số liệu này với đơn giá input/output token của mô hình để dự toán ngân sách. Chi phí thực tế còn phụ thuộc vào cơ chế tính phí và tài nguyên sử dụng. Với LLM, doanh nghiệp cũng cần quản lý cửa sổ ngữ cảnh (Context Window) để cân đối lượng tài liệu, lịch sử hội thoại và phần trả lời trong giới hạn token của mô hình.
Vì vậy, trước khi mở rộng AI Inference, doanh nghiệp nên kiểm thử chất lượng phản hồi, độ trễ, khả năng chịu tải, bảo mật và chi phí để lựa chọn mô hình cùng hạ tầng phù hợp.
Dưới đây là những câu hỏi phổ biến giúp người đọc hiểu rõ hơn về yêu cầu phần cứng, khả năng học hỏi và sự khác biệt giữa AI Inference với AI Reasoning.
Không bắt buộc. AI Inference có thể chạy trên CPU, GPU hoặc bộ tăng tốc AI chuyên dụng như TPU, NPU. Việc lựa chọn phụ thuộc vào quy mô mô hình, tốc độ phản hồi và khối lượng yêu cầu. GPU thường phù hợp với các mô hình lớn hoặc tác vụ cần xử lý song song.
Thông thường là không. Trong quá trình inference, mô hình sử dụng các tham số đã được huấn luyện để tạo kết quả mà không tự cập nhật chúng. Muốn cải thiện kiến thức hoặc năng lực của mô hình thông qua thay đổi tham số, cần có quá trình huấn luyện hoặc fine-tuning riêng. Nếu chỉ cần bổ sung thông tin từ tài liệu doanh nghiệp khi trả lời, hệ thống có thể dùng RAG để truy xuất dữ liệu và đưa vào ngữ cảnh suy luận mà không cập nhật tham số mô hình.
Không hoàn toàn. AI Inference là quá trình thực thi mô hình để tạo kết quả từ dữ liệu đầu vào. Trong khi đó, AI Reasoning đề cập đến khả năng suy luận, phân tích và giải quyết vấn đề của hệ thống AI. Các tác vụ reasoning có thể được thực hiện thông qua một hoặc nhiều lần inference.
Hiểu rõ AI Inference là gì giúp doanh nghiệp nhận diện vai trò của quá trình suy luận trong việc đưa mô hình AI đã huấn luyện vào ứng dụng thực tế. Hiệu quả triển khai không chỉ phụ thuộc vào chất lượng mô hình mà còn ở dữ liệu đầu vào, tốc độ xử lý và chi phí vận hành.
Vì vậy, doanh nghiệp nên ưu tiên giải pháp đáp ứng nhu cầu nghiệp vụ thay vì chỉ lựa chọn mô hình có quy mô lớn.
 Ứng dụng AI
BIZFLY AI - HỆ SINH THÁI GIẢI PHÁP AI CHO DOANH NGHIỆP
AI Agent giúp tối ưu nguồn lực và chi phí, giúp doanh nghiệp phát triển bền vững trong kỷ nguyên AI